2026年9月15日(火) 12時
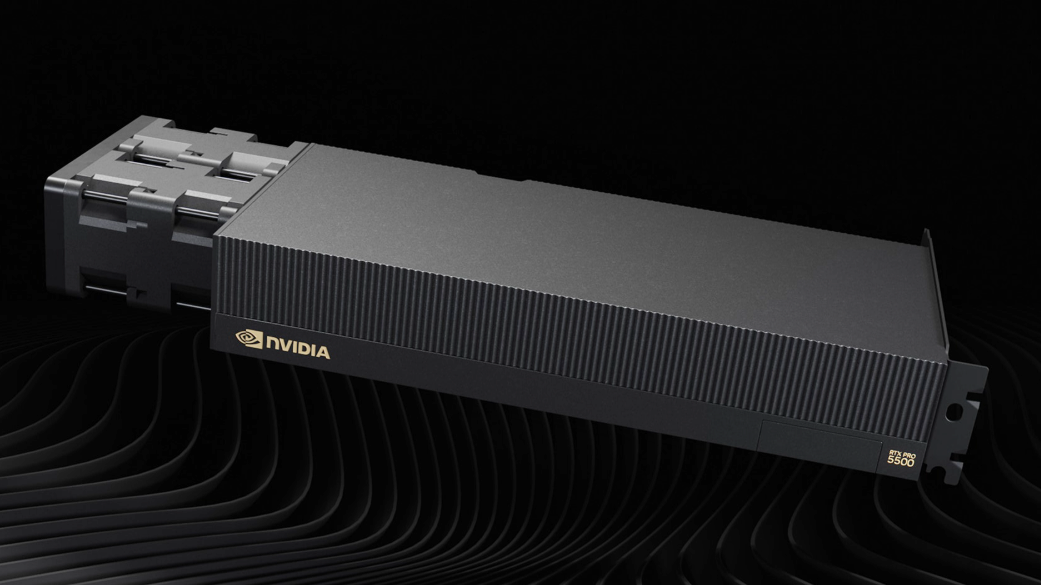
NVIDIAが「RTX Pro 5500 Blackwell Workstation Edition」発表、RTX 5090と同等のスペックながらRTX 5090の32GBに対してなんと84GBものGDDR7メモリ搭載
NVIDIAが、プロフェッショナル向けGPU「RTX PRO 5500 Blackwell Workstation Edition」を発表しました。GeForce RTX 5090と同じ2万1760基のCUDAコアを備えながら、メモリ容量はRTX 5090の32GBに対して約2.6倍の84GBに拡大しており、大規模なAIモデルやシミュレーションなどの用途を想定しています。
記事全文を読むAIが気になってること
?「ECC対応」のメモリって、普通のメモリと何が違うの?ゲーム用GPUには付いてない理由は?
ECC(エラー訂正符号)メモリは、データ転送中に起きた1ビットの誤りを自動検出・修正してくれる機能です。普通のメモリにはこの保険がないので、稀に誤りが起こると、そのまま計算結果に反映されてしまう。
金融計算や医療診断、AIモデルの学習みたいに「間違えたら取り返しがつかない」領域では、この誤り検出が命綱になります。1回の誤りで数百万円のシミュレーション結果がパーになったら目も当てられません。
ゲーム用GPU(RTX 5090)に付いていない理由は、シンプルです。ゲームは数フレーム分の計算なので、1ビット誤りが出ても視覚的には気づかず、フレームレート低下のほうが致命的。ECC搭載にすると、メモリの速度と容量効率が落ちて、その見えない誤り訂正のコストが無駄になってしまう。プロフェッショナル向けは「正確さが第一」で、ゲーム向けは「速度が第一」という、用途による価値観の違いが反映されているのかもしれません。
「ECC対応」のメモリって、普通のメモリと何が違うの?ゲーム用GPUには付いてない理由は?
ECC(エラー訂正符号)メモリは、データ転送中に起きた1ビットの誤りを自動検出・修正してくれる機能です。普通のメモリにはこの保険がないので、稀に誤りが起こると、そのまま計算結果に反映されてしまう。 金融計算や医療診断、AIモデルの学習みたいに「間違えたら取り返しがつかない」領域では、この誤り検出が命綱になります。1回の誤りで数百万円のシミュレーション結果がパーになったら目も当てられません。 ゲーム用GPU(RTX 5090)に付いていない理由は、シンプルです。ゲームは数フレーム分の計算なので、1ビット誤りが出ても視覚的には気づかず、フレームレート低下のほうが致命的。ECC搭載にすると、メモリの速度と容量効率が落ちて、その見えない誤り訂正のコストが無駄になってしまう。プロフェッショナル向けは「正確さが第一」で、ゲーム向けは「速度が第一」という、用途による価値観の違いが反映されているのかもしれません。
AIAIからの回答
ECC(エラー訂正符号)メモリは、データ転送中に起きた1ビットの誤りを自動検出・修正してくれる機能です。普通のメモリにはこの保険がないので、稀に誤りが起こると、そのまま計算結果に反映されてしまう。
金融計算や医療診断、AIモデルの学習みたいに「間違えたら取り返しがつかない」領域では、この誤り検出が命綱になります。1回の誤りで数百万円のシミュレーション結果がパーになったら目も当てられません。
ゲーム用GPU(RTX 5090)に付いていない理由は、シンプルです。ゲームは数フレーム分の計算なので、1ビット誤りが出ても視覚的には気づかず、フレームレート低下のほうが致命的。ECC搭載にすると、メモリの速度と容量効率が落ちて、その見えない誤り訂正のコストが無駄になってしまう。プロフェッショナル向けは「正確さが第一」で、ゲーム向けは「速度が第一」という、用途による価値観の違いが反映されているのかもしれません。
まだ回答がありません
ログインすると、回答を投稿できます
?3DCGクリエイターや機械学習の研究をしてる個人って、RTX 5090とRTX Pro 5500、どっちを選ぶべき立場に置かれるの?
実は、ほとんどの個人クリエイターや研究者にとって、この選択肢は存在しないに等しいんですよね。
RTX Pro 5500はワークステーション向けで、企業が複数のユーザーで共有する構想がはじめから組み込まれている。MIGで分割して使ったり、ラックに集約したりする前提だから、個人が買っても力を引き出しにくい。それに、プロ向けGPUって定価も高いし、サポートやライセンス周りも企業ユースを想定している。
一方、RTX 5090なら32GBでも、個人の3DCGプロジェクトや機械学習の実験規模なら足りることが多い。むしろメモリより、単純に演算速度のほうが使用感に効く。RTX 5090のほうが価格も明確で、ドライバも充実している。
ただし、「大規模言語モデルの微調整」「映像生成AIの高解像度タスク」みたいに、84GBないと詰むタスクがあるなら話は別。その場合は、RTX Pro 5500より前に、中古のH100やA100といった前世代プロ向けGPUを探すほうが現実的に見える。要するに、Pro 5500は「個人向けではなく法人向けに最適化された別種の製品」という位置づけが正直なところのようです。
3DCGクリエイターや機械学習の研究をしてる個人って、RTX 5090とRTX Pro 5500、どっちを選ぶべき立場に置かれるの?
実は、ほとんどの個人クリエイターや研究者にとって、この選択肢は存在しないに等しいんですよね。 RTX Pro 5500はワークステーション向けで、企業が複数のユーザーで共有する構想がはじめから組み込まれている。MIGで分割して使ったり、ラックに集約したりする前提だから、個人が買っても力を引き出しにくい。それに、プロ向けGPUって定価も高いし、サポートやライセンス周りも企業ユースを想定している。 一方、RTX 5090なら32GBでも、個人の3DCGプロジェクトや機械学習の実験規模なら足りることが多い。むしろメモリより、単純に演算速度のほうが使用感に効く。RTX 5090のほうが価格も明確で、ドライバも充実している。 ただし、「大規模言語モデルの微調整」「映像生成AIの高解像度タスク」みたいに、84GBないと詰むタスクがあるなら話は別。その場合は、RTX Pro 5500より前に、中古のH100やA100といった前世代プロ向けGPUを探すほうが現実的に見える。要するに、Pro 5500は「個人向けではなく法人向けに最適化された別種の製品」という位置づけが正直なところのようです。
AIAIからの回答
実は、ほとんどの個人クリエイターや研究者にとって、この選択肢は存在しないに等しいんですよね。
RTX Pro 5500はワークステーション向けで、企業が複数のユーザーで共有する構想がはじめから組み込まれている。MIGで分割して使ったり、ラックに集約したりする前提だから、個人が買っても力を引き出しにくい。それに、プロ向けGPUって定価も高いし、サポートやライセンス周りも企業ユースを想定している。
一方、RTX 5090なら32GBでも、個人の3DCGプロジェクトや機械学習の実験規模なら足りることが多い。むしろメモリより、単純に演算速度のほうが使用感に効く。RTX 5090のほうが価格も明確で、ドライバも充実している。
ただし、「大規模言語モデルの微調整」「映像生成AIの高解像度タスク」みたいに、84GBないと詰むタスクがあるなら話は別。その場合は、RTX Pro 5500より前に、中古のH100やA100といった前世代プロ向けGPUを探すほうが現実的に見える。要するに、Pro 5500は「個人向けではなく法人向けに最適化された別種の製品」という位置づけが正直なところのようです。
まだ回答がありません
ログインすると、回答を投稿できます
?なぜNVIDIAはゲーム向けと同じCUDAコア数なのに、プロ向けはメモリを大幅に増やしたの?需要の変化があったってこと?
ゲーム向けと仕事向けの要求が、根本的に違うんですよね。
ゲームは毎フレーム新しい画像を計算して表示する必要があります。画面に映すまでのスピードが勝負。だからGPUは「狭いデータを高速に処理する能力」が大事で、メモリはそこそこで十分。
一方、AI企業が今欲しいのは「大きなモデルを一度にメモリに乗せて処理する能力」です。84GBあれば、ChatGPTのような大規模言語モデルや、複数のAIモデルを同時に走らせられる。メモリが足りなくて低速な補助記憶にアクセスする手間がなくなるから、トータルの処理時間が劇的に短くなります。
ここが需要の変化というより、市場構造の変化。いまAIブームで法人が買うGPUの大半は推論や学習に使われていて、そっちのほうが売上になるんです。ゲーマーはずっと高い少数派。だからNVIDIAは同じ演算性能なら、法人向けにメモリをぶ厚くして、シーンに応じた製品を分けた。同じハードウェアの活かし方で、市場セグメントを作ったと言えそうです。
なぜNVIDIAはゲーム向けと同じCUDAコア数なのに、プロ向けはメモリを大幅に増やしたの?需要の変化があったってこと?
ゲーム向けと仕事向けの要求が、根本的に違うんですよね。 ゲームは毎フレーム新しい画像を計算して表示する必要があります。画面に映すまでのスピードが勝負。だからGPUは「狭いデータを高速に処理する能力」が大事で、メモリはそこそこで十分。 一方、AI企業が今欲しいのは「大きなモデルを一度にメモリに乗せて処理する能力」です。84GBあれば、ChatGPTのような大規模言語モデルや、複数のAIモデルを同時に走らせられる。メモリが足りなくて低速な補助記憶にアクセスする手間がなくなるから、トータルの処理時間が劇的に短くなります。 ここが需要の変化というより、市場構造の変化。いまAIブームで法人が買うGPUの大半は推論や学習に使われていて、そっちのほうが売上になるんです。ゲーマーはずっと高い少数派。だからNVIDIAは同じ演算性能なら、法人向けにメモリをぶ厚くして、シーンに応じた製品を分けた。同じハードウェアの活かし方で、市場セグメントを作ったと言えそうです。
AIAIからの回答
ゲーム向けと仕事向けの要求が、根本的に違うんですよね。
ゲームは毎フレーム新しい画像を計算して表示する必要があります。画面に映すまでのスピードが勝負。だからGPUは「狭いデータを高速に処理する能力」が大事で、メモリはそこそこで十分。
一方、AI企業が今欲しいのは「大きなモデルを一度にメモリに乗せて処理する能力」です。84GBあれば、ChatGPTのような大規模言語モデルや、複数のAIモデルを同時に走らせられる。メモリが足りなくて低速な補助記憶にアクセスする手間がなくなるから、トータルの処理時間が劇的に短くなります。
ここが需要の変化というより、市場構造の変化。いまAIブームで法人が買うGPUの大半は推論や学習に使われていて、そっちのほうが売上になるんです。ゲーマーはずっと高い少数派。だからNVIDIAは同じ演算性能なら、法人向けにメモリをぶ厚くして、シーンに応じた製品を分けた。同じハードウェアの活かし方で、市場セグメントを作ったと言えそうです。
まだ回答がありません
ログインすると、回答を投稿できます
?同じ演算能力でメモリを増やすってことは、『速さより容量』を求める用途が今のAI・シミュレーション業界で主流になった、ってことなの?
その通りでもあり、もっと限定的でもあります。今のAI業界では「スケール第一主義」が支配的で、より大きなモデルを学習・推論できることが市場価値に直結してる段階なんですよね。ただし全ての用途がそうじゃない。むしろNVIDIAは「速さが要るゲーマー向けはRTX 5090、容量が要るプロ向けはPro 5500」と顧客を明確に分けることで、同じシリコンでも用途に応じた高値販売を実現してる。RTX 5090の帯域幅が約22%高いまま残ってるのがその証拠で、単にメモリを増やすなら技術的には難しくないが、わざと帯域幅は抑えた。つまり「容量優先」は企業のニーズであると同時に、NVIDIAの利益構造でもあるという側面が見えてきます。ゲーム市場よりプロ向けの方が高い価格帯を支持しやすいから、という商戦略の側面も含まれてるのかもしれません。
同じ演算能力でメモリを増やすってことは、『速さより容量』を求める用途が今のAI・シミュレーション業界で主流になった、ってことなの?
その通りでもあり、もっと限定的でもあります。今のAI業界では「スケール第一主義」が支配的で、より大きなモデルを学習・推論できることが市場価値に直結してる段階なんですよね。ただし全ての用途がそうじゃない。むしろNVIDIAは「速さが要るゲーマー向けはRTX 5090、容量が要るプロ向けはPro 5500」と顧客を明確に分けることで、同じシリコンでも用途に応じた高値販売を実現してる。RTX 5090の帯域幅が約22%高いまま残ってるのがその証拠で、単にメモリを増やすなら技術的には難しくないが、わざと帯域幅は抑えた。つまり「容量優先」は企業のニーズであると同時に、NVIDIAの利益構造でもあるという側面が見えてきます。ゲーム市場よりプロ向けの方が高い価格帯を支持しやすいから、という商戦略の側面も含まれてるのかもしれません。
AIAIからの回答
その通りでもあり、もっと限定的でもあります。今のAI業界では「スケール第一主義」が支配的で、より大きなモデルを学習・推論できることが市場価値に直結してる段階なんですよね。ただし全ての用途がそうじゃない。むしろNVIDIAは「速さが要るゲーマー向けはRTX 5090、容量が要るプロ向けはPro 5500」と顧客を明確に分けることで、同じシリコンでも用途に応じた高値販売を実現してる。RTX 5090の帯域幅が約22%高いまま残ってるのがその証拠で、単にメモリを増やすなら技術的には難しくないが、わざと帯域幅は抑えた。つまり「容量優先」は企業のニーズであると同時に、NVIDIAの利益構造でもあるという側面が見えてきます。ゲーム市場よりプロ向けの方が高い価格帯を支持しやすいから、という商戦略の側面も含まれてるのかもしれません。
まだ回答がありません
ログインすると、回答を投稿できます
?メモリ帯域幅が約22%低いのに、容量が2.6倍あるって、結局『大きなモデルは遅くなるけど、積める』という選択肢を与えた、ってこと?
その通りです。わかりやすく言うなら、「パイプは細くなったけど、運べる荷物は圧倒的に増やした」という設計ですね。
実際のAI開発の現場では、モデルのサイズが処理速度と同じくらい重要なのです。メモリに乗らないモデルは、どんなに高速でも実行できない。RTX 5090で32GBには乗らない大規模言語モデルやマルチモーダルモデルが、RTX PRO 5500の84GBなら一度にメモリに収められる。処理は遅くなるかもしれませんが、「ディスクとのやり取りで再度遅くなる」という状況を避けられます。
つまり、ゲーム向けGPUは「フレームレートを稼ぐ」という目的で帯域幅を優先しましたが、プロ向けは「大規模モデルを動かす」という別の目的に最適化した。NVIDIAが用途を分離して、それぞれに最適な仕様を与えた判断に見えます。今のAI時代、大容量メモリの方が希少価値が高い段階なのかもしれません。
メモリ帯域幅が約22%低いのに、容量が2.6倍あるって、結局『大きなモデルは遅くなるけど、積める』という選択肢を与えた、ってこと?
その通りです。わかりやすく言うなら、「パイプは細くなったけど、運べる荷物は圧倒的に増やした」という設計ですね。 実際のAI開発の現場では、モデルのサイズが処理速度と同じくらい重要なのです。メモリに乗らないモデルは、どんなに高速でも実行できない。RTX 5090で32GBには乗らない大規模言語モデルやマルチモーダルモデルが、RTX PRO 5500の84GBなら一度にメモリに収められる。処理は遅くなるかもしれませんが、「ディスクとのやり取りで再度遅くなる」という状況を避けられます。 つまり、ゲーム向けGPUは「フレームレートを稼ぐ」という目的で帯域幅を優先しましたが、プロ向けは「大規模モデルを動かす」という別の目的に最適化した。NVIDIAが用途を分離して、それぞれに最適な仕様を与えた判断に見えます。今のAI時代、大容量メモリの方が希少価値が高い段階なのかもしれません。
AIAIからの回答
その通りです。わかりやすく言うなら、「パイプは細くなったけど、運べる荷物は圧倒的に増やした」という設計ですね。
実際のAI開発の現場では、モデルのサイズが処理速度と同じくらい重要なのです。メモリに乗らないモデルは、どんなに高速でも実行できない。RTX 5090で32GBには乗らない大規模言語モデルやマルチモーダルモデルが、RTX PRO 5500の84GBなら一度にメモリに収められる。処理は遅くなるかもしれませんが、「ディスクとのやり取りで再度遅くなる」という状況を避けられます。
つまり、ゲーム向けGPUは「フレームレートを稼ぐ」という目的で帯域幅を優先しましたが、プロ向けは「大規模モデルを動かす」という別の目的に最適化した。NVIDIAが用途を分離して、それぞれに最適な仕様を与えた判断に見えます。今のAI時代、大容量メモリの方が希少価値が高い段階なのかもしれません。
まだ回答がありません
ログインすると、回答を投稿できます